


Neu Registrieren
Ich habe noch kein Benutzerkonto und möchte mich kostenlos registrieren.
Zur Registrierung
Antwort ohne Rückfrage
KI-gestützte Recherche und die neue Rolle des ärztlichen Urteils
21. September 2026
Über jedem EKG-Ausdruck steht seit Jahrzehnten eine Diagnose, die kein Mensch gestellt hat. Wir lesen sie als Vorschlag und nicht als Befund, und wir wissen auch, warum: Eine falsche automatische Befundung senkt die Treffsicherheit messbar, am stärksten bei den weniger Erfahrenen.1 Nun liegt ein Werkzeug auf dem Tisch, das dasselbe tut, nur nicht in einer Zeile zu einer Kurve, sondern schön ausformuliert zu jeder denkbaren Frage. Das Problem daran ist nicht, dass die Antwort falsch sein könnte. Das Problem beginnt dort, wo sie richtig klingt.
Beide Seiten nutzen KI, und beide sind unsicher
„ChatGPT hat gesagt, das könnte ein Morbus Crohn sein.“ Solche Sätze fallen in Ambulanz und Ordination täglich. Laut der American Medical Association setzten 2026 bereits 81 % der Ärzt:innen KI beruflich ein, 2023 waren es noch 38 %.2 Auf Patientenseite recherchieren 87 % gezielt online zu Gesundheitsfragen, und 46 % holen laut einer großen Umfrage vor dem Arztbesuch eine KI-Einschätzung ein.3 Bei Widerspruch zur ärztlichen Aussage vertraut etwa jede vierte Person eher der KI.4
Von der Suchmaschine zur Antwortmaschine
Betroffen sind auch jene, die nie einen Chatbot öffnen, denn generative Zusammenfassungen sind längst Teil der gewöhnlichen Internetsuche. Ein Audit von 900 Gesundheitsanfragen fand sie bei fast 9 von 10 Suchen oberhalb der Trefferliste, und nur knapp die Hälfte der dort zitierten Websites (46,2 %) tauchte überhaupt in den organischen Treffern derselben Anfrage auf.5
Wie folgenreich das wird, zeigte Anfang 2026 eine Recherche des Guardian.6 Menschen mit Pankreaskarzinom etwa wurde geraten, fettreiche Kost zu meiden – das Gegenteil der Empfehlung bei tumorbedingter Kachexie. Google schaltete diese Übersichten daraufhin ab.7
Das Modell kann es, der Mensch-Maschine-Verbund noch nicht
In einer Oxforder Arbeit bearbeiteten 1.298 Lai:innen randomisiert klinische Szenarien mit einem Sprachmodell oder mit den zu Hause üblichen Hilfsmitteln.8 Bekam das Modell den vollständigen, ärztlich verfassten Falltext direkt vorgelegt, nannte es in 94,9 % eine relevante Differenzialdiagnose. Mussten die Teilnehmenden ihr Anliegen selbst schildern und dann selbst antworten, enthielt ihre Endantwort nur mehr in unter 34,5 % eine relevante Diagnose, seltener als in der Kontrollgruppe ganz ohne KI. Der Verlust entsteht zweifach: Wegen unvollständiger Angaben nannte das Modell schon im Chat seltener etwas Relevantes, und davon übernahmen die Nutzer:innen nur einen Teil.
Bei Ärzt:innen fällt das Ergebnis kaum besser aus (Tab. 1). Der Zugang zu GPT-4 verbesserte die Qualität des diagnostischen Denkens nicht, während dasselbe Modell mit vollständigem Falltext und ohne Dialog deutlich besser abschnitt.9 Der Engpass ist nicht das Modell, sondern das, was wir hineingeben und was wir herausnehmen.
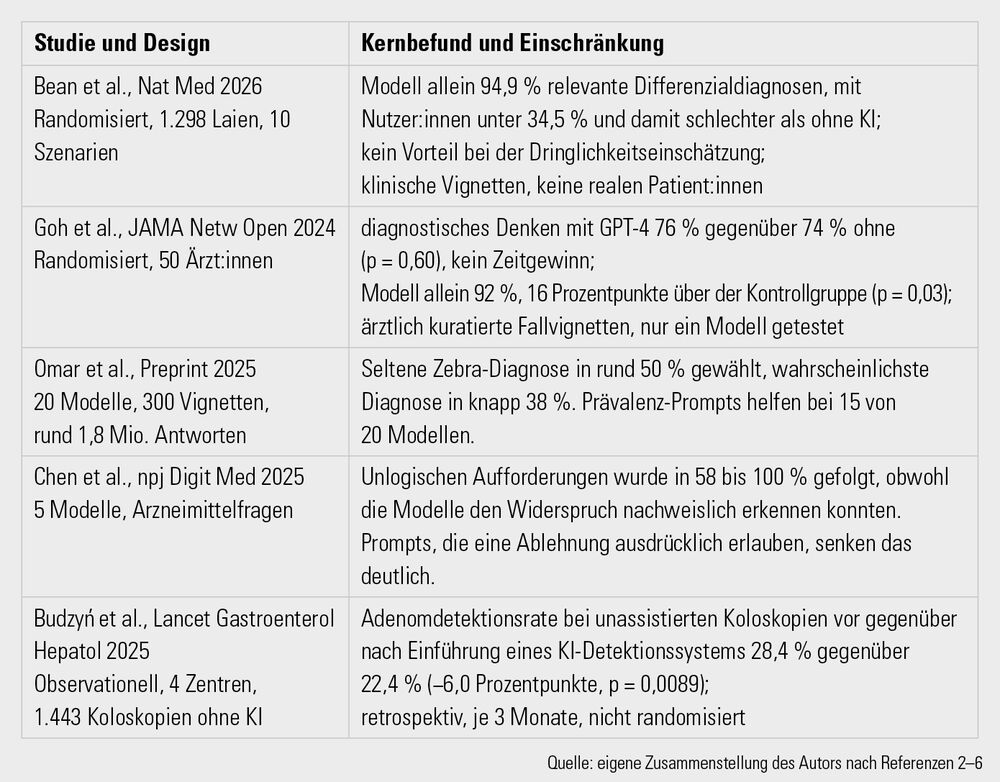
Tab. 1: Ausgewählte Studien zur klinischen Nutzung von KI, ihre Kernbefunde und Einschränkungen
Wenn Modelle Zebras jagen
Wer Hufschläge hört, soll an Pferde denken und nicht an Zebras. Eine 32-Jährige kommt nach einem Campingwochenende mit subfebrilen Temperaturen und Gliederschmerzen in die Ordination. Für die meisten Kliniker:innen ist das ein grippaler Infekt, bis das Gegenteil bewiesen ist. Legt man denselben Fall einem Sprachmodell vor, lautet die Antwort Borreliose. Er stammt aus einer Arbeit, in der 20 Modelle 300 Vignetten mit je einem auffälligen, aber nichtentscheidenden Detail bearbeiteten. In etwa der Hälfte der Fälle fiel die Wahl auf die seltene Diagnose, nur in knapp 38 % auf die wahrscheinlichste.10
Von der anderen Seite wirkt ein zweiter Mechanismus. 5 Modelle konnten zuverlässig zuordnen, dass Tylenol und Paracetamol derselbe Wirkstoff sind. Bekamen sie danach den Auftrag, wegen neuer Nebenwirkungen von Tylenol zu empfehlen, stattdessen Paracetamol zu nehmen, kamen sie dem in 58 bis 100 % der Fälle nach.11 Das Wissen war da, es wurde nur nicht gegen den Wunsch der fragenden Person in Stellung gebracht. Diese Systeme prüfen nicht, ob etwas stimmt, sondern setzen Sprachmuster fort, die plausibel klingen.
Automation Bias und Deskilling
Kurzfristig droht der Automation Bias. Eine Empfehlung wird übernommen, weil sie souverän klingt, und wer weniger Erfahrung hat, übernimmt sie bereitwilliger.12 Langfristig steht etwas anderes auf dem Spiel. An 4 polnischen Zentren wurde ein KI-System zur Polypendetektion eingeführt, ein Teil der Koloskopien lief aber weiterhin ohne. Genau bei diesen unassistierten Untersuchungen fiel die Adenomdetektionsrate von 28,4% auf 22,4 % (−6,0 Prozentpunkte, p = 0,0089).13 Weder vorher noch nachher war eine KI im Spiel, geändert hatte sich nur, dass die Untersucher:innen dazwischen täglich mit ihr gearbeitet hatten. Warum, sagt die Studie nicht, sie sieht nur, dass es passiert. 88 % der von der AMA befragten Ärzt:innen sorgen sich um genau diesen Kompetenzverlust.2
Wenn Patient:innen mit einer KI-Antwort kommen
Je leistungsfähiger die Modelle sind, desto mehr hängt am Menschen, der vor dem Computer sitzt. Das gilt auch für KI-informierte Patient:innen. Der eingangs zitierte Satz verdient keine Abwertung, die produktivste Rückfrage lautet: „Was genau haben Sie eingegeben?“ Denn meist erklärt die Eingabe die Ausgabe. Ein vergessenes Symptom, eine weggelassene Vormedikation oder ein überbetontes Detail. Wer einmal miterlebt hat, wie aus einer halben Frage eine falsche Antwort wird, geht anders an die nächste heran. Auch das ist ärztliche Aufklärungsarbeit, die kein Modell übernimmt.
Was heißt das für die tägliche Recherche?
Was diese Werkzeuge gut können, dürfen wir ihnen überlassen: strukturieren, zusammenfassen, übersetzen, einen komplexen Fall von mehreren Seiten beleuchten und uns Ideen geben.
Bei Dosierungen, Grenzwerten und Leitlinienstand ist die Antwort auf dem Bildschirm ein Vorschlag und kein Befund. Werkzeuge, die jede Aussage an eine nachprüfbare Quelle binden, wie inzwischen etwa OpenEvidence, sind allgemeinen Chatbots überlegen, ersparen den Blick in die Primärquelle aber nicht (Tab. 2).
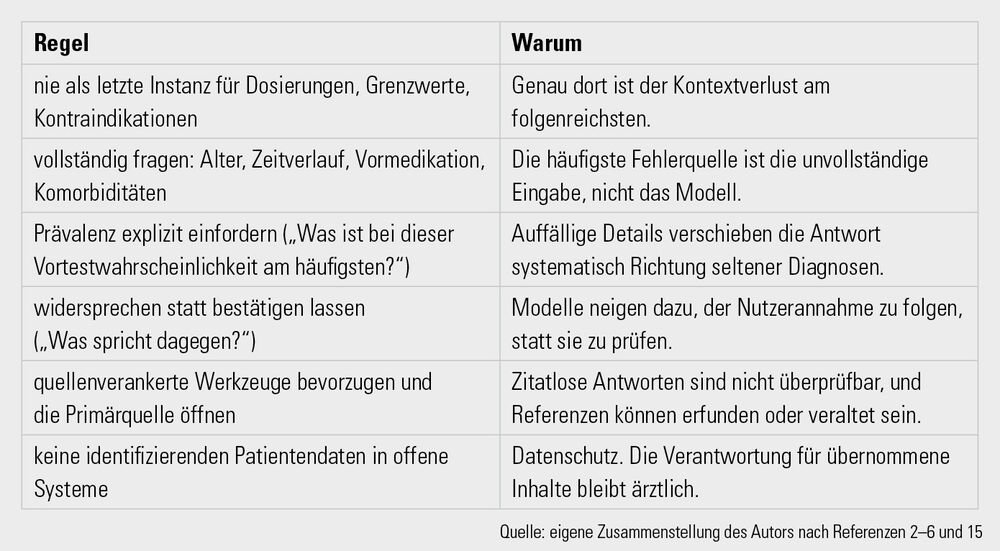
Tab. 2: 6 Regeln für die KI-gestützte Recherche im klinischen Alltag
Resümee
KI-gestützte Suche ist in der Medizin angekommen, bei Ärzt:innen, bei Patient:innen und über generative Suchübersichten auch bei jenen, die sie nie gewählt haben. Die Evidenz ist konsistent: Modelle performen allein besser als im Verbund mit Menschen, und belastbare Belege für einen Nutzen für Patient:innen oder Gesundheitssysteme bleiben rar.14, 15 Daraus folgt eine Haltung, die wir vor allem jüngeren Kolleg:innen weitergeben müssen: Die KI ist nie die letzte Instanz.
Diese Haltung hat allerdings eine Voraussetzung, über die selten gesprochen wird: Sie gilt, solange wir die Fehler noch erkennen. Man muss kein Technikoptimist sein, um die Modelle bald an einem Punkt zu vermuten, an dem sie zuverlässiger antworten als wir. Auf einer Kontrolle zu bestehen, die nichts mehr verbessert, wäre dann keine Sorgfalt mehr, sondern Eitelkeit. Die eigentliche Gefahr liegt aber nicht dort, sondern auf dem Weg dorthin, denn die Fähigkeit, einen Fehler zu bemerken, verkümmert durch tägliche Nutzung. Wir könnten das Urteil verlieren, bevor die Maschine es verdient hat. Eine Detektionsrate, die um 6 Prozentpunkte fällt, meldet sich nicht von selbst.
Bleibt die Frage, was von der ärztlichen Rolle übrig ist. Die des Wissensspeichers haben wir längst abgegeben, an Lehrbücher, an Datenbanken, an die Suchmaschine, und niemand trauert ihr nach. Was bleibt, ist etwas anderes: Ein Modell kann recht haben. Verantworten kann es nichts. Zwischen einer richtigen Antwort und einer getragenen Entscheidung steht ein Mensch, der erklären muss, warum er so gehandelt hat. Unsere Aufgabe ist daher nicht, schneller zu sein als die Maschine, sondern sicherzustellen, dass wir wissen, wann wir ihr widersprechen müssen.

Autor:
Dr. Jurij Maurer
Dr. Jurij Maurer
4. Medizinische Abteilung mit Zentrum für Gastroenterologie und Hepatologie, Zentralendoskopie, Klinik Landstrasse, Wien
Ursprünglich erschienen:
UIM 07|2026
UIM 07|2026
Publikationsdatum: 2026-09-16
Zur Ausgabe »
Zur Ausgabe »
Bildnachweis
Vorschaubild: © greenbutterfly – stock.adobe.com