

Neu Registrieren
Ich habe noch kein Benutzerkonto und möchte mich kostenlos registrieren.
Zur Registrierung
KI in der Intensivmedizin
Noch keine Wunderwaffe, aber wertvolle Unterstützung am Krankenbett
28. September 2026
UIM: Wenn es um Krankheitsvorhersage mittels KI speziell in Ihrer Disziplin, der Intensivmedizin, geht: Welche Entwicklungen/Ereignisse lassen sich heute grundsätzlich vorhersagen, und wo sind die Grenzen solcher Prognosen?
Prof. Kimberger: Grundsätzlich ist zu sagen, dass KI natürlich nicht Zukunft vorhersagen, sondern nur Wahrscheinlichkeiten berechnen kann. Das heißt, man kann mit Algorithmen und Modellen die Wahrscheinlichkeit abschätzen, ob sich zum Beispiel der Zustand von Patient:innen verschlechtern wird, ob sie eine Sepsis oder ein Nierenversagen bekommen oder respiratorisch Hilfe benötigen werden, aber nicht, ob ein Ereignis zu 100 Prozent eintreten wird oder auszuschließen ist. Gerade in der Anästhesie und Intensivmedizin besteht zusätzlich die Schwierigkeit, dass sehr viel in der Erforschung von optimalen Therapien im Fluss ist und es viele verschiedene Ansätze für viele verschiedene Pathologien und Therapieinterventionen gibt. Selbst wenn ein Ereignis mit einer gewissen Wahrscheinlichkeit vorhergesagt wird, ist die KI deshalb derzeit nicht imstande, im Einzelfall eindeutig zu empfehlen, welche optimalen Behandlungsmaßnahmen man setzen sollte.
Gerade die Sepsis ist ein gutes Beispiel, weil es hier immer noch eine sehr hohe Mortalität gibt und unterschiedliche Strategien erforscht werden, um sie zu senken – mit der grundsätzlichen Idee, dass man das vermutlich personalisiert machen muss, dass es verschiedene Arten von Sepsis gibt, dass Sepsis-Patient:innen also von unterschiedlichen Behandlungen profitieren könnten. Aber gerade weil das eben noch nicht so klar ist, ist es natürlich auch mit einem Algorithmus nicht möglich, die einzig wahre und beste Behandlung für die individuellen Patient:innen zu definieren.
Welche Daten und in welcher Qualität braucht es, um Krankheitsrisiken oder klinische Verschlechterungen mittels KI sinnvoll abschätzen zu können?
Das hängt sehr von der Pathologie selbst ab. Eine Sepsis ist deutlich komplexer als ein gebrochenes Bein. Bezüglich der Daten ist es wichtig, dass man möglichst viele hat und diese in entsprechender Qualität vorliegen müssen. Gerade auf der Intensivstation mit den elektronischen Patientendaten-Management-Systemen haben wir natürlich optimale Voraussetzungen, weil man hier Zeitreihen einspeisen kann, die für die Verlaufsprognose sehr wichtig sind und anhand derer die KI äußerst zeitnah ausrechnen kann, in welche Richtung die Reise geht – sprich: Vitalparameter, Laborwerte, Blutgase, EKG, Beatmungsgeräte etc. Das wird ja oft minütlich oder noch höher aufgelöst aufgezeichnet und bedeutet damit eine sehr wertvolle Information für die KI.
Prinzipiell ist die Qualität der Daten, mit denen man einen Algorithmus füttert, natürlich von wesentlicher Bedeutung. Es ist problematisch, wenn die Daten fehlerhaft, unvollständig oder verspätet zur Verfügung stehen, ganz besonders, wenn die Fehler nicht nur rein zufällig, sondern systematisch sind. Einen entsprechenden Bias kann man gar nicht gänzlich vermeiden, weil tendenziell bestimmte Bevölkerungsgruppen zwangsläufig in den Trainingsdaten unterrepräsentiert sind oder fehlen. Wenn der Algorithmus auf solche Bevölkerungsgruppen angewendet wird, funktioniert das dann gegebenenfalls schlechter als bei der Mehrheitsbevölkerung.
Wer übernimmt die Verantwortung für Fehleinschätzungen der KI?
Im Moment ist das relativ klar: Die KI gibt einen Hinweis bzw. eine Einschätzung, die richtig oder falsch sein kann. Die Ärzt:innen müssen das beurteilen und tragen dann die Verantwortung, weil die letzte Entscheidung weiterhin von ihnen getroffen werden muss. Natürlich gibt es auch Produkthaftung. Das heißt, wenn ein Gerät systematisch Fehler macht, liegt die Haftung eher beim Hersteller. Aber grundsätzlich arbeitet eine KI mit Wahrscheinlichkeiten, die im Gesamtkontext eingeschätzt werden müssen. Das muss den Anwender:innen klar sein, sie müssen auch entsprechend eingewiesen sein und sind entsprechend letztverantwortlich.
Schlüsselaspekte beim Einsatz und Training von KI-Anwendungen gerade in der Medizin sind der Datenschutz und die zentrale Speicherung von Patientendaten. Wie funktioniert „Federated Learning“ als IT-Workaround für einen verantwortungsvollen Umgang mit sensiblen Patientendaten?
Bis dato war es oft so, dass die Daten von verschiedenen Krankenhäusern zentral gepoolt wurden, dann wurde der Algorithmus entsprechend darauf angesetzt und optimiert. Bei „Federated Learning“ bleiben die Daten in den Krankenhäusern, und der Algorithmus wird von einer zentralen Stelle an die Krankenhäuser geschickt. Dort wird lokal die Performance überprüft und das Ergebnis ans Zentrum rückgemeldet. Dann kommt es zu entsprechenden Optimierungsmaßnahmen, und das wird iterativ gemacht, d. h., zwischen den diversen Krankenhäusern, die in diesem föderierten System hängen, und der Trainingszentrale, bis der Algorithmus entsprechend optimiert ist. Der entscheidende Vorteil besteht darin, dass die Daten, die doch oft sehr umfangreich und sensibel sind, das KH gar nicht verlassen müssen.
Wie ändert sich die ärztliche Entscheidungsfindung, wenn künftige Risikoeinschätzungen von der KI kommen?
Im Moment noch nicht entscheidend: Die KI fungiert mehr oder weniger wie erfahrene Kolleg:innen oder wie ein zusätzliches Paar Augen, das Hinweise mit bestimmten Wahrscheinlichkeiten auf das Auftreten von bestimmten Pathologien geben kann. Die fallverantwortlichen Ärzt:innen müssen überprüfen, ob der KI-Input im individuellen Kontext überhaupt sinnvoll bzw. plausibel ist. Das heißt, die KI unterstützt, aber ersetzt nicht die ärztliche Entscheidungsfindung. Es gibt einige Studien, die zeigen, dass die KI, wenn sie gut in den Workflow integriert ist, tatsächlich die klinische Behandlung verbessern kann. Aber das ist eben eine der großen Herausforderungen: wie man die KI gut und sinnvoll in einen Workflow integriert. Das funktioniert manchmal gut, aber oft auch nicht: Wenn z.B. von den KI-Systemen sehr viele Alarme einlangen, vielleicht auch Fehlalarme, kann es sehr leicht zu Alarmmüdigkeit kommen. Das könnte zukünftig ein großes Problem werden, wenn Ärzt:innen dann die Algorithmen ignorieren. Ein weiteres Risiko besteht durch den sogenannten Automation-Bias, wenn Ärzt:innen sich irgendwann nur noch auf die KI verlassen bzw. sich im Zweifelsfall auf der sicheren Seite wähnen, wenn sie der KI glauben, anstatt ihr zu widersprechen, und die eigene Entscheidungskompetenz und Ratio hintanstellen bzw. wenn die ärztlichen „Skills“ durch blindes Vertrauen in die KI verloren gehen.
Besteht im Hintergrund nicht ein prinzipieller Konflikt mit dem klassischen ärztlichen Selbstverständnis, alleinverantwortlich die beste Therapieentscheidung treffen zu können, wenn aufgrund der Komplexität nicht transparent ist, auf welcher Basis und nach welchen Kriterien der Vorschlag des Algorithmus entstanden ist, dem man nun zu folgen aufgefordert ist?
Das ist völlig richtig. Allerdings ist es so, dass es mittlerweile immer verstärkter in die Richtung von „explainable KI“ geht: Die Algorithmen, die eingesetzt werden, haben schon sehr häufig Explainable-Anteile, wenn sie ans Krankenbett kommen, d. h., sie erklären, warum sie glauben, dass sich z. B. Sepsis entwickeln wird oder eine Hypotonie droht. Das wird auch als sehr wichtig angesehen, ist schon in viele dieser Algorithmen eingebaut und verbessert ihren Nutzen und die Glaubwürdigkeit deutlich.
In welchen Bereichen ist KI heute schon in den klinischen Alltag integrierbar, und was ist noch Zukunftsmusik?
KI, die man heute schon in den klinischen Alltag integrieren kann und wahrscheinlich auch bald soll, sind solche mit sehr eng umschriebenen, stark begrenzten Aufgaben: Sie unterstützen typischerweise bei der Auswertung von radiologischen Bildern, von Biosignalen, können Priorisierungen oder Triagen machen, etwa den Blutverbrauch vorhersagen oder die Notwendigkeit, dass jemand nach einer OP auf eine Intensivstation kommt. Was es noch nicht gibt, das ist die Universal-KI, die über alle Gesundheitsdaten von Patient:innen verfügt und dann vorhersagt, welche Krankheiten sie in den nächsten Jahren entwickeln werden, und schon gar nicht eine, die imstande ist, zu errechnen, was genau für individuelle Patient:innen die beste Therapie ist. Da gibt es noch immer sehr viele Daten, die noch nicht in die Modelle eingeflossen sind: etwa Lebensstil, Genetik, gesellschaftliche Entwicklungen, Umwelt etc. Das kann man zwar isoliert abbilden, aber für eine valide Integration ist das noch etwas zu komplex.
Woran aktuell sehr intensiv gearbeitet wird, ist die Optimierung von Therapien in die Richtung Personalized Medicine. Da ist der Bereich des verstärkenden Lernens ganz wesentlich, wo verschiedene Szenarien durchgespielt werden und man versucht, herauszufinden, bei welchem die jeweiligen Patient:innen am besten aussteigen.
Dabei drängt sich die Frage auf: Wenn es möglich sein wird, eine präzise Therapieentscheidung aufgrund einer individualisierten KI-Berechnung zu treffen, werden Leitlinien in der Form, wie sie jetzt existieren, dann überhaupt noch notwendig sein?
Es ist zwar sehr wahrscheinlich, dass es irgendwann einmal tatsächlich in die Richtung geht, dass strenge Leitlinien und fixe Abläufe für die Patient:innen einem personalisierten Ansatz weichen werden. Allerdings glaube ich, dass wir bis dahin noch einen längeren Weg vor uns haben.
Vielen Dank für das Interview!
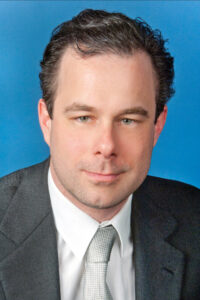
Interview mit:
Univ.-Prof. Dr. Oliver Kimberger, MBA MSc
Univ.-Prof. Dr. Oliver Kimberger, MBA MSc
Klinische Abteilung für Allgemeine Anästhesie und Intensivmedizin, Universitätsklinik für Anästhesie, Allgemeine Intensivmedizin und Schmerztherapie, Medizinische Universität Wien
Redaktion:
Peter Lex
Peter Lex
Ursprünglich erschienen:
UIM 07|2026
UIM 07|2026
Publikationsdatum: 2026-09-16
Zur Ausgabe »
Zur Ausgabe »
Bildnachweis
Vorschaubild: © MMS